// یادداشت پروژه
ساخت DocIntel برای یادگیری پردازش اسناد و RAG
چرا برای کار با پایتون، embedding و بازیابی اطلاعات سراغ یک اپلیکیشن فولاستک رفتم؛ از رابط Nuxt تا بکاند FastAPI و PostgreSQL.
خواندن مطلبsouth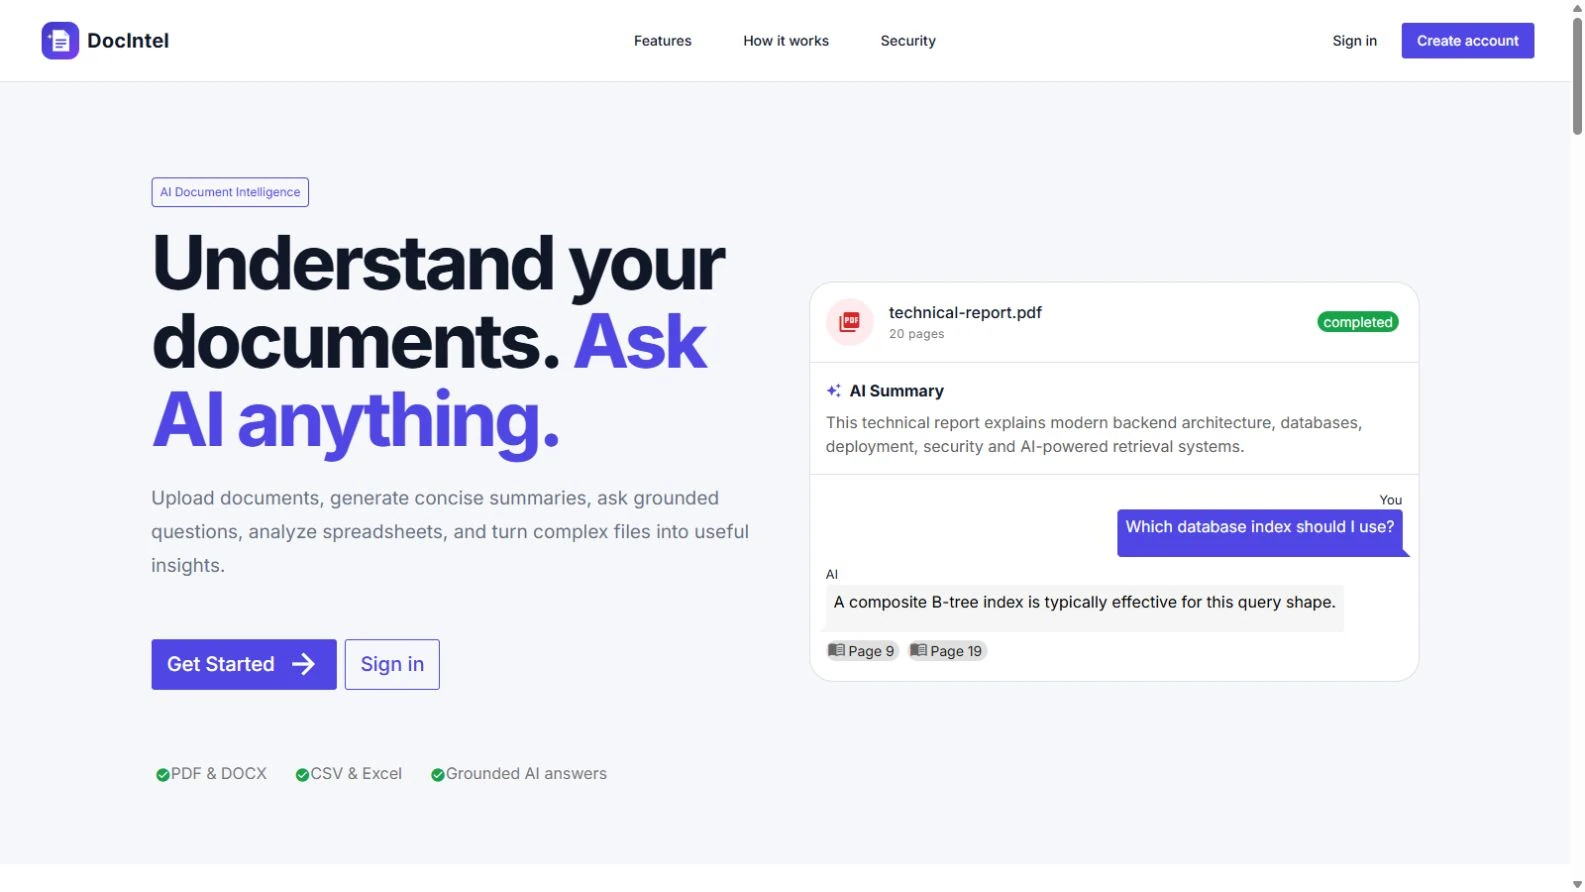
یادگیری با کنار هم گذاشتن بخشهای واقعی
میخواستم در کنار کار فولاستک، جدیتر سراغ Python، هوش مصنوعی، مدلهای زبانی، embedding و RAG برم. بهجای اینکه فقط دوره ببینم و تمرینهای کوچیک انجام بدم، تصمیم گرفتم یه اپلیکیشن بر پایهٔ همین موضوعها بسازم.
نتیجه شد DocIntel؛ یک پلتفرم اسناد که آپلود، سازماندهی، پردازش، خلاصهسازی و سؤال پرسیدن رو توی یک داشبورد کنار هم میذاره.
بیشتر از یک کادر پرسش
- آپلود و مدیریت اسناد.
- استخراج و پردازش محتوای سند.
- تولید خلاصه با کمک هوش مصنوعی.
- پرسیدن سؤال دربارهٔ محتوای سند با RAG.
- پیدا کردن بخشهای مرتبط با embedding و جستوجوی برداری.
- مرتب کردن اسناد با پوشه، تگ و علاقهمندیها در یک داشبورد با احراز هویت.
- سندآپلود، استخراج و پردازش محتوا
- Embeddingنمایش محتوا برای بازیابی برداری
- بازیابیپیدا کردن بخشهای مرتبط با سؤال
- پاسخاستفاده از محتوای بازیابیشده در فرایند RAG
رابط وب در کنار بکاند پایتون
برای فرانتاند از Nuxt، Vue، TypeScript و Quasar استفاده کردم. بکاند با Python، FastAPI، SQLAlchemy و PostgreSQL ساخته شده و pgvector هم برای نگهداری و جستوجوی برداری استفاده میشه. بخش هوش مصنوعی شامل OpenAI API، embedding و RAG هست.
کار روی این لایهها تجربهٔ بهتری از اتصال توسعهٔ وب به قابلیتهای هوش مصنوعی بهم داد. معماری بکاند، دیتابیس برداری، پردازش سند و احراز هویت باید توی یک محصول کنار هم درست کار میکردن.
پروژهای برای ادامه دادن
DocIntel برام راهی بود برای فهمیدن ارتباط این بخشها، نه فقط فرستادن یک درخواست به مدل. یکی از قدمهای جدی اولم در ساخت اپلیکیشنهای مجهز به هوش مصنوعی بود و میخوام توسعهش رو ادامه بدم.
صفحهٔ پروژه، لینک پیشنمایش فرانتاند و کد بکاند رو داره. پیشنمایش فرانتاند جداگانه در دسترسه؛ بکاند پایتون همراه اون دمو میزبانی نشده، ولی کدش برای بررسی پیادهسازی در دسترسه.